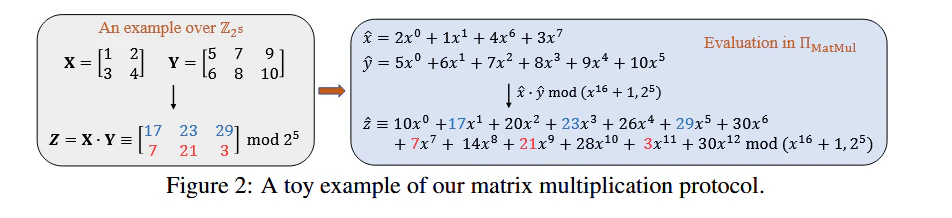Iron: Private Inference on Transformers

Abstract

一种基于 Transformer 的隐私推理框架,提供了一套面向矩阵乘法和非线性运算的新型安全协议。第一,提出针对于同态加密下矩阵乘法的一种新型紧凑打包,这种设计减少了 m\sqrt{m} 倍通信开销。第二,对于 Softmax、GELU、LayerNorm 提出了优化。实现表明,Iron achieves 3 ∼ 14× less communication and 3 ∼ 11× less runtime compared to the prior art.

所要解决的问题:

  • 服务端不希望自己的模型权重发送给客户端,避免模型被盗取。
  • 客户端不希望自己的隐私数据泄露给服务端。
  • 能否有这样一种协议,使客户端得到计算结果 y=f(x,W)y = f(x, W),同时双方都不泄露各自的数据。
  • 针对于线性层的矩阵乘法问题,Transformer-based model 使用了大量高维度的矩阵乘法,而不是被更广泛研究的矩阵向量乘法,两者并不互通。
  • 针对于非线性层问题,Transformer-based model 使用的数学运算对于加密场景(尤其是非线性函数)并不友好。

Knowledge

2PC

在 “互不信任” 且 “不泄露私有数据” 的前提下,实现 f(x,y)f(x, y) 的协同计算。
  • 安全性底线:服务器 P0P_0 看不见用户的输入,客户端 P1P_1 也拿不到服务器的模型权重。
拆分逻辑 (The Splitting):
  • 原理:将原始数据 xx 物理拆碎,满足 x=⟨x⟩0+⟨x⟩1(mod2l)x = \langle x \rangle_0 + \langle x \rangle_1 \pmod{2^l}。
  • 分配:
    • ⟨x⟩0=r\langle x \rangle_0 = r(随机数):发送给服务器。
    • ⟨x⟩1=x−r\langle x \rangle_1 = x - r(差值份额):保留在客户端。

AES

在隐私计算中,同态加密被定义为一个四元组算法 AHE=(KeyGen, Enc, Dec, Eval)\text{AHE} = (\text{KeyGen, Enc, Dec, Eval}):
  • KeyGen (密钥生成):产生一对非对称密钥。
    • 公钥 (pkpk):公开的“加密锁”,任何人均可用其将明文转化为密文。
    • 私钥 (sksk):私有的“解密匙”,仅数据所有者持有,用于还原明文。
  • Enc (加密):映射过程 m^∈AN,p→pkc^∈AN,q\hat{m} \in \mathbb{A}_{N,p} \xrightarrow{pk} \hat{c} \in \mathbb{A}_{N,q}。将明文多项式编码并隐藏。
  • Dec (解密):逆映射过程 c^→skm^\hat{c} \xrightarrow{sk} \hat{m}。利用私钥将密文多项式还原。
  • Eval (同态求值):核心精髓。在无需解密的前提下,对密文进行算术运算。
    • 加法同态:Dec(Eval(c^1,c^2,⊞))=m1+m2\text{Dec}(\text{Eval}(\hat{c}_1, \hat{c}_2, \boxplus)) = m_1 + m_2
    • 标量乘法同态:Dec(m^plain⊠c^cipher)=mplain⋅mcipher\text{Dec}(\hat{m}_{plain} \boxtimes \hat{c}_{cipher}) = m_{plain} \cdot m_{cipher}
同态加密的底层安全性基于 LWE (Learning With Errors) 及其变体,这导致了“噪声”的存在:
  • 噪声积聚 (Noise Growth):每次执行 Eval\text{Eval}(尤其是乘法运算)时,密文中的随机噪声会呈指数级或线性增长。
  • 解密上限:一旦噪声超过了方案设定的临界阈值,密文将发生“雪崩效应”,导致解密后的数据彻底失效。
  • 自举 (Bootstrapping):这是消除噪声的“核武器”。它通过在密文状态下运行解密电路,将高噪声密文刷新为低噪声密文。

OT

1. 标准 kk 选 1 不经意传输 (k-OTℓk\text{-OT}_\ell)
这是隐私计算中的“盲选”原语,确保交互过程的双向匿名性。
  • 角色与输入:
    • 发送者 (Sender):持有 kk 个消息 x0,x1,…,xk−1x_0, x_1, \dots, x_{k-1}。
    • 接收者 (Receiver):持有一个私有索引 i∈[k]i \in [k]。
  • 隐私保证 (Security):
    • 发送者侧:完全不知道接收者选择了哪一个消息(ii 对发送者不可见)。
    • 接收者侧:只能获得自己选择的 xix_i,对其他 k−1k-1 个消息一无所知(其余消息对接收者不可见)。
2. Iron 中的高效变体:相关 OT (2-COTℓ2\text{-COT}_\ell)
为了压榨推理性能,Iron 大量使用了结构性更强的相关 OT。它的精妙之处在于将 “逻辑选择” 直接转化为了 “代数关系”。
  • 角色与输入:
    • 发送者 (Sender):输入一个相关值 x∈Z2ℓx \in \mathbb{Z}_{2^\ell}(通常是权重或中间计算值)。
    • 接收者 (Receiver):输入一个选择位 i∈{0,1}i \in \{0, 1\}(通常是份额的符号位或逻辑标志)。
  • 协议输出 (Outputs):
    • 发送者得到:一个随机数 rr。
    • 接收者得到:r+i⋅xr + i \cdot x。

Overview

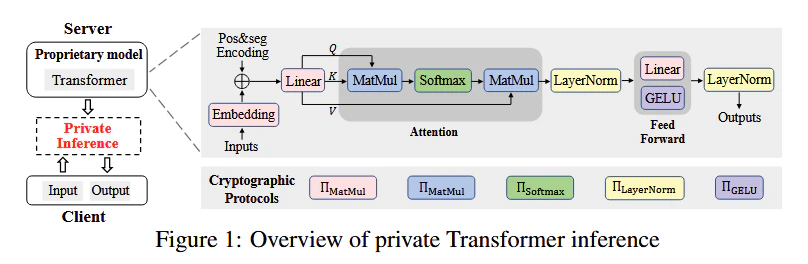
image-20260411211609446

1. 注意力层 (Attention Layer)

A. 生成 Q,K,VQ, K, V (份额 ×\times 权重)
以 Query 矩阵为例: ⟨XQ⟩=ΠMatMul(⟨X⟩1,WQ)+⟨X⟩0WQ\langle \mathbf{X}_Q \rangle = \Pi_{MatMul}(\langle \mathbf{X} \rangle_1, \mathbf{W}_Q) + \langle \mathbf{X} \rangle_0 \mathbf{W}_Q
  • 本地项:⟨X⟩0WQ\langle \mathbf{X} \rangle_0 \mathbf{W}_Q。由于服务器 P0P_0 既有权重又有自己的那份碎片,它可以直接在本地算,无需任何通信。
  • 协议项:只有针对客户端份额 ⟨X⟩1\langle \mathbf{X} \rangle_1 的部分才需要动用同态加密。
B. 计算分数 XQK=XQXKT\mathbf{X}_{QK} = \mathbf{X}_Q \mathbf{X}_K^T (份额 ×\times 份额)
这是两个碎片之间的乘法,根据分配律拆解为四项: ⟨XQK⟩=ΠMatMul(⟨XQ⟩0,⟨XK⟩1)+ΠMatMul(⟨XQ⟩1,⟨XK⟩0)⏟交叉项:调用两次安全乘法+⟨XQ⟩0⟨XK⟩0T+⟨XQ⟩1⟨XK⟩1T⏟自乘项:双方本地直算\langle \mathbf{X}_{QK} \rangle = \underbrace{\Pi_{MatMul}(\langle \mathbf{X}_Q \rangle_0, \langle \mathbf{X}_K \rangle_1) + \Pi_{MatMul}(\langle \mathbf{X}_Q \rangle_1, \langle \mathbf{X}_K \rangle_0)}_{\text{交叉项:调用两次安全乘法}} + \underbrace{\langle \mathbf{X}_Q \rangle_0 \langle \mathbf{X}_K \rangle_0^T + \langle \mathbf{X}_Q \rangle_1 \langle \mathbf{X}_K \rangle_1^T}_{\text{自乘项:双方本地直算}}
  • 见解:通过这种拆分,原本需要 4 次加密乘法的任务,被削减为 2 次,剩下的 2 次变成了免费的本地矩阵运算。

Solution

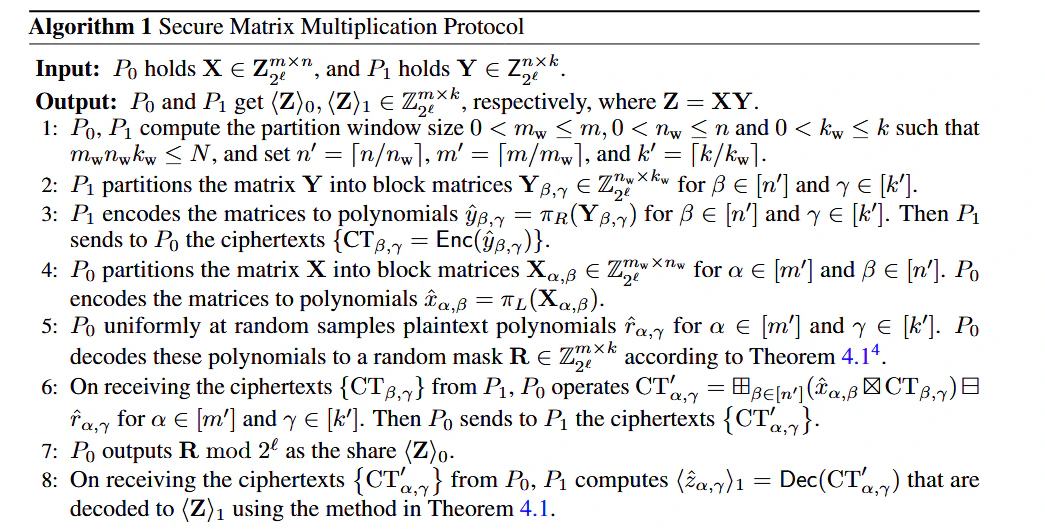
Protocol for Matrix Multiplication

Iron 的思路:
  • 紧凑打包(Compact Packing):将矩阵元素平铺在多项式的系数里。
  • 维度并行:利用 mw×nw×kwm_w \times n_w \times k_w 三维窗口,同时在多项式内完成多个内积运算。
  • 混合计算:利用秘密共享特性,将计算拆分为“本地项”与“协议项”,减少密文运算量。
窗口约束条件: 协议通过寻找一组最优的窗口参数 (mw,nw,kw)(m_w, n_w, k_w),必须满足: mw⋅nw⋅kw≤Nm_w \cdot n_w \cdot k_w \le N 其中 NN 是多项式阶数。这确保了一个加密“集装箱”能装下所有必要的计算位且互不干扰。 双向编码映射:
  • πR(Y)\pi_R(Y)(右编码):客户端 P1P_1 将矩阵 YY 的元素按照特定步长填入多项式系数。
  • πL(X)\pi_L(X)(左编码):服务器 P0P_0 将矩阵 XX 进行旋转并编码。
x^=πL(X), s.t. x^[i⋅n⋅k+(n−1)−j]=X[i,j], for i∈[m],j∈[n]\hat{x} = \pi_L(\mathbf{X}), \text{ s.t. } \hat{x}[i \cdot n \cdot k + (n - 1) - j] = \mathbf{X}[i, j], \text{ for } i \in [m], j \in [n] y^=πR(Y), s.t. y^[j⋅n+i]=Y[i,j], for i∈[n],j∈[k]\hat{y} = \pi_R(\mathbf{Y}), \text{ s.t. } \hat{y}[j \cdot n + i] = \mathbf{Y}[i, j], \text{ for } i \in [n], j \in [k] 还原过程: 当 P1P_1 收到 P0P_0 发回的密文并解密得到多项式 z^\hat{z} 后,他并不需要看所有的系数,而是根据预设的索引逻辑提取结果: 矩阵 Z\mathbf{Z} 中第 (i,j)(i, j) 个元素(其中 0≤i<mw,0≤j<kw0 \le i < m_w, 0 \le j < k_w)被映射到了多项式 z^\hat{z} 的特定系数位置: Z[i][j]=z^[i+j⋅mw⋅nw]\mathbf{Z}[i][j] = \hat{z}[i + j \cdot m_w \cdot n_w] 服务器 P0P_0:他手里只有自己生成的随机掩码 R\mathbf{R},于是他直接输出 ⟨Z⟩0=R(mod2l)\langle \mathbf{Z} \rangle_0 = \mathbf{R} \pmod{2^l}。 客户端 P1P_1:他解密出的结果多项式其实是 z^total=(x^⋅y^−r^)\hat{z}_{total} = (\hat{x} \cdot \hat{y} - \hat{r})。
  • 按照上述公式 Z[i][j]=z^[i+j⋅mw⋅nw]\mathbf{Z}[i][j] = \hat{z}[i + j \cdot m_w \cdot n_w] 提取出数值。
  • 由于 r^\hat{r} 是 P0P_0 随机生成的掩码,P1P_1 提取出的值就是 ⟨Z⟩1=(XY−R)(mod2l)\langle \mathbf{Z} \rangle_1 = (\mathbf{X}\mathbf{Y} - \mathbf{R}) \pmod{2^l}
image-20260411213526373 image-20260411213557723

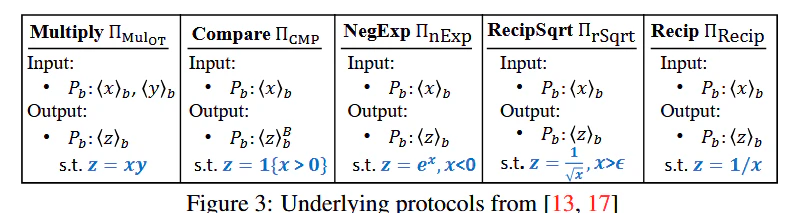
Protocols for Non-linear Functions

image-20260411212705226

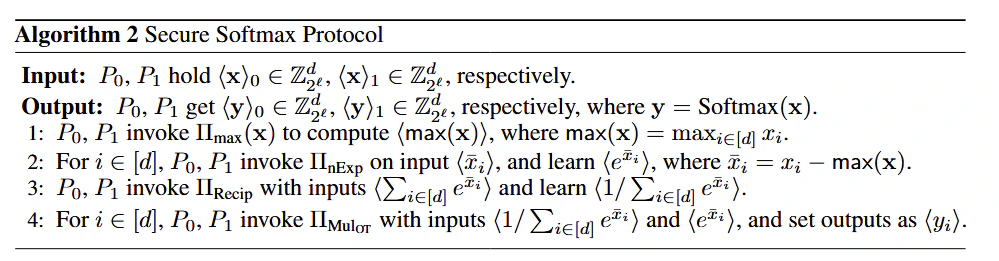
Softmax

Softmax 的标准公式为 yi=exi∑exjy_i = \frac{e^{x_i}}{\sum e^{x_j}}。为了防止指数爆炸,Iron 采用如下形式: yi=Softmax(xi)=exi−max⁡(x)∑j=1dexj−max⁡(x)y_i = \text{Softmax}(x_i) = \frac{e^{x_i - \max(\mathbf{x})}}{\sum_{j=1}^d e^{x_j - \max(\mathbf{x})}} 第一步:安全寻最(Πmax⁡\Pi_{\max})
  • 动作:P0,P1P_0, P_1 协作通过二叉树约减协议找出向量 x\mathbf{x} 中的最大值。
  • 目的:通过计算 xˉi=xi−max⁡(x)\bar{x}_i = x_i - \max(\mathbf{x}),确保后续指数运算的输入始终 ≤0\le 0。
  • 密码学原语:使用之前提到的 ΠCMP\Pi_{CMP}(比较)和 ΠMulOT\Pi_{Mul_{OT}}。
第二步:负指数运算(ΠnExp\Pi_{nExp})
  • 动作:计算 ⟨exˉi⟩\langle e^{\bar{x}_i} \rangle。
  • 技术见解:计算正指数 exe^x 在有限域内极易溢出。Iron 专门设计了 ΠnExp\Pi_{nExp}(Negative Exponential) 协议,通过多项式近似或查表法(LUT)在密文状态下高效计算负指数。
  • 结果:得到每个元素的指数份额。
第三步:求和与倒数(ΠRecip\Pi_{Recip})
  • 动作:先在本地累加所有指数份额(线性运算,无需通信),然后调用 ΠRecip\Pi_{Recip}(Reciprocal) 协议计算总和的倒数:⟨1/∑exˉi⟩\langle 1 / \sum e^{\bar{x}_i} \rangle。
  • 难点:倒数运算在定点数(Fix)环境下对精度极其敏感,通常需要通过牛顿迭代法或专门的 2PC 倒数协议完成。
第四步:最终合成(ΠMulOT\Pi_{Mul_{OT}})
  • 动作:将“倒数份额”与“各元素的指数份额”相乘。
  • 公式:⟨yi⟩=⟨exˉi⟩⋅⟨1/∑exˉj⟩\langle y_i \rangle = \langle e^{\bar{x}_i} \rangle \cdot \langle 1 / \sum e^{\bar{x}_j} \rangle。
  • 原语:调用 ΠMulOT\Pi_{Mul_{OT}} 完成最后这一步跨份额的乘法。
image-20260411214108273

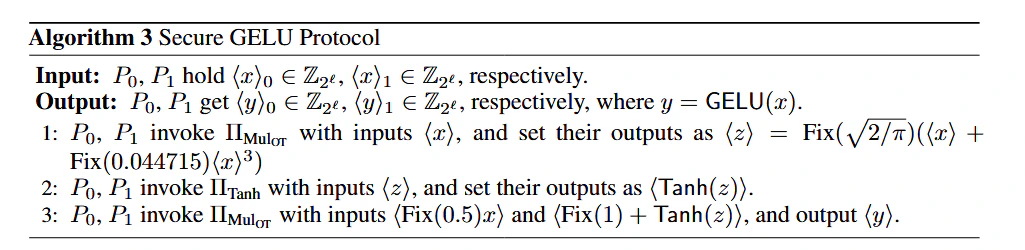
GELU

为了在 2PC 环境下计算,GELU 被近似表达为以下公式: y=GELU(x)≈0.5x(1+tanh⁡(2/π(x+0.044715x3)))y = \text{GELU}(x) \approx 0.5x \left( 1 + \tanh \left( \sqrt{2/\pi} (x + 0.044715x^3) \right) \right) 高阶项合成(三次幂计算): x3=(⟨x⟩0+⟨x⟩1)3=⟨x⟩03+⟨x⟩13⏟本地可算项+3⟨x⟩02⟨x⟩1+3⟨x⟩0⟨x⟩12⏟交叉项(必须调用协议)x^3 = (\langle x \rangle_0 + \langle x \rangle_1)^3 = \underbrace{\langle x \rangle_0^3 + \langle x \rangle_1^3}_{\text{本地可算项}} + \underbrace{3\langle x \rangle_0^2 \langle x \rangle_1 + 3\langle x \rangle_0 \langle x \rangle_1^2}_{\text{交叉项(必须调用协议)}} Iron 并不直接实现 Tanh\text{Tanh},而是利用 Sigmoid\text{Sigmoid} 协议进行复用: tanh⁡(z)=2σ(2z)−1\tanh(z) = 2\sigma(2z) - 1 其中 σ(x)=11+e−x\sigma(x) = \frac{1}{1 + e^{-x}}。 image-20260411215504657

LayerNorm

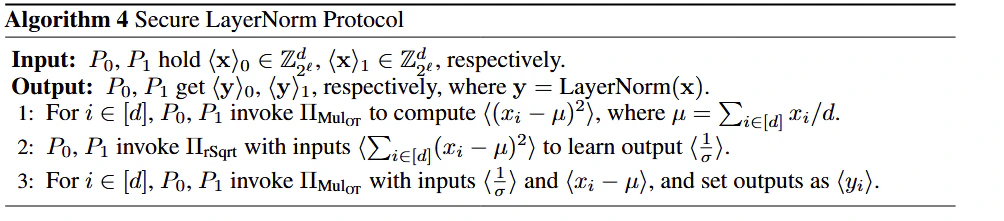
LayerNorm 的标准公式为: yi=xi−μσ,其中 μ=1d∑xi,σ=1d∑(xi−μ)2y_i = \frac{x_i - \mu}{\sigma}, \quad \text{其中 } \mu = \frac{1}{d} \sum x_i, \quad \sigma = \sqrt{\frac{1}{d} \sum (x_i - \mu)^2} 步骤 I:离差平方的并行计算 (算 (xi−μ)2(x_i - \mu)^2)
  • 计算均值 μ\mu(本地完成): 由于 μ=(∑xi)/d\mu = (\sum x_i) / d 是线性运算,且 dd(维度)是公开常数。
    • P0P_0 在本地计算 ⟨μ⟩0=(∑⟨xi⟩0)/d\langle \mu \rangle_0 = (\sum \langle x_i \rangle_0) / d。
    • P1P_1 在本地计算 ⟨μ⟩1=(∑⟨xi⟩1)/d\langle \mu \rangle_1 = (\sum \langle x_i \rangle_1) / d。
    • 优势:此步零通信。
  • 计算离差 xi−μx_i - \mu(本地完成): 双方本地执行减法,得到 ⟨xi−μ⟩\langle x_i - \mu \rangle。
  • 计算平方项(协作完成): 为了得到 ⟨(xi−μ)2⟩\langle (x_i - \mu)^2 \rangle,双方必须针对每个维度 i∈[d]i \in [d] 调用一次 ΠMulOT\Pi_{\text{Mul}_{\text{OT}}}。
    • 逻辑:这是一个秘密份额自乘的过程,需要处理 (a+b)2=a2+2ab+b2(a+b)^2 = a^2 + 2ab + b^2 中的交叉项 2ab2ab。
步骤 II:平方根倒数的隐私近似 (算 1/σ1/\sigma)
  • 输入:双方在本地对步骤 I 的结果求和,得到方差的原始份额 ⟨Var⋅d⟩\langle \text{Var} \cdot d \rangle。
  • 核心动作:调用 ΠrSqrt\Pi_{\text{rSqrt}} (Root Inverse Square) 协议。
  • 实现原理:
    1. 范围归一化:将输入缩放到特定区间。
    2. 多项式近似:利用二阶或三阶多项式(如 f(x)≈ax2+bx+cf(x) \approx ax^2 + bx + c)来逼近 1/x1/\sqrt{x} 函数。
    3. 计算:多项式的计算过程依然通过 ΠMulOT\Pi_{\text{Mul}_{\text{OT}}} 来完成。
  • 输出:得到 ⟨1/σ⟩\langle 1/\sigma \rangle 的秘密份额。
步骤 III:最终缩放合成(算 yiy_i)
  • 动作:双方针对每个维度 ii,调用 ΠMulOT\Pi_{\text{Mul}_{\text{OT}}}。
  • 输入项:⟨1/σ⟩\langle 1/\sigma \rangle 和 ⟨xi−μ⟩\langle x_i - \mu \rangle。
  • 输出:产生最终结果 ⟨yi⟩\langle y_i \rangle。
image-20260411220004801